太平洋夏令时间 6 月 23-25 日,Adobe 如期举办了一年一度的 DITAWORLD 大会。
Adobe DITAWORLD 大会自 2016 年开始举办,每年一届,今年已是第十一届。大会面向全球观众直播(免费注册),旨在为市场营销和技术传播两个领域的专业人士搭建一个互相沟通的桥梁,每年吸引上万名技术传播、市场营销、内容管理和内容策略方面的专业人士在线观看。
虽然大会是免费观看的,但由于开会时间正值北京时间的半夜 12 点至早上五六点钟左右(今年还撞上了世界杯),很多中国观众可能因为要熬通宵而不得不放弃。会后,Adobe 会将所有视频上传到 YouTube,让无法观看直播的观众免费观看回放,但中国观众好像也不太方便……
前几年,我都是注册时热情洋溢,临近直播时就被会议时间默默地劝退了。但今年,我做足了思想准备和行动实施方面的功课,完整看完了全部三天的直播!
本文集中整理本次大会上关于行业发展趋势的主流观点、国际大厂正在实施的内容战略、行业大神的独家洞察以及 Adobe 在内容管理领域的主力产品 AEM Guides 的最新进展等。绝大部分内容与 AI 和规模化的内容管理有关,希望能为业内人士提供一些参考。
行业前瞻
在本次大会上,Adobe 产品高级总监 Vivek Kumar 按照惯例做开场演讲,针对 AI 热潮下的内容信任危机提出了自己的看法和解决方案。除此之外,大会还组织了三场小组讨论,重点关注 AI 给技术传播及相关从业人员带来的机遇、风险和应对之策。
AI 会促进访问平权,同时会曝光企业的文档债,引发内容信任危机。Vivek Kumar 指出,AI 让技术文档的使用方式从导航和搜索变成了问答式对话,内容的访问量和权重将完全取决于用户需求,而不是导航设计。一些藏得比较深、常年无人问津的内容,可能会因为用户的随口一问而突然蹦到 AI 的回答里。如果你的文档里有任何维护不周的地方,AI 会将它们统统摊到用户面前,引起用户的质疑和信任危机,甚至带来法律风险。
夯实内容基础设施,构建内容循环工程,让 AI 越来越聪明。解决内容信任危机的关键,不是使用更好的大模型,而是通过结构化和关系构建将内容转化为知识,为 AI 提供可靠的信息来源。如果将用户与 AI 的每一次交互产生的数据进行收集、整理和分析,再根据分析结果优化内容,就会进一步提升 AI 体验,形成正向反馈循环。
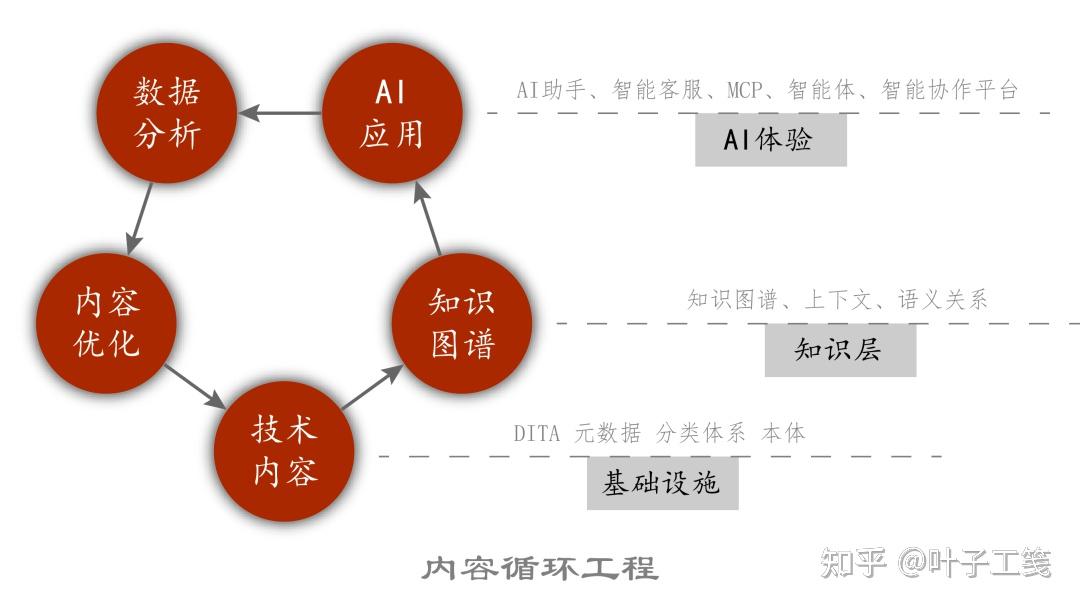
结构化内容不再只是文档基础设施,也成了 AI 基础设施。许多企业只关注 AI 应用,觉得它能立竿见影,很拉风。但长远来看,选择在基础设施上投资的人会成为最后的赢家。
AI 可以为个人和企业赋能,但也有可能会动摇长期发展的根基。利用 AI,我们可以做很多以前做不了的事情,也可以甩掉一些无聊的苦差事。小组讨论时,每个嘉宾都有无比自豪的 AI 时刻。比如,技术传播学教授以前必须半夜三更请 DITA 大神们帮忙做的事情,现在自己可以借助赛博编程搞定了;内容服务团队利用 AI 生成软件更新说明,不需要自己亲自写这种无聊的文档了;技术文档团队可以借助 AI 编写代码示例,不必请研发团队在百忙之中抽时间来“帮忙”了;企业中的外国员工,借助 AI 翻译也可以使用非母语贡献内容了……
不过,AI 提供的便捷和效率也可能会让新手员工和团队产生依赖,或者失去打基础、掌握核心技能和培养员工的机会。比如,DITA 新手可以使用 AI 直接生成 DITA 内容,不愿意花时间学习基础知识;企业使用 AI 智能体构建了自动化流程,员工没有机会通过工作实践积累经验。当遇到异常情况时,没有人知道如何处理。即使坚持人机协同,如果员工没有实操经验,就不具备管理工作流程的能力。
稳步实施 AI 战略,支持人机协同,向公众科普 AI 的真实能力。几乎所有嘉宾都认为,AI 不能完全取代人类,人机协同是最好的选择。此前,已有不少企业因为激进的 AI 策略而自食其果,比如瑞典著名的金融科技公司 Klarna 和美国知名的体育周刊《体育画报》。但这些新闻产生的社会影响以及 AI 剽窃等争议,让很多人抵制 AI。抵制 AI 的人群,不只有担心工作不保的上班族,还有大学里的教职工和各个专业的学生。大家担心失业,担心(数据中心等引起的)环境问题,担心 AI 会让人类丧失独立思考的能力。因此,向公众科普 AI 的真实能力和伦理边界、为推进 AI 创建一个包容性的社会环境至关重要。
学好专业知识,积极探索新领域新工具,保持平和的心态。AI 时代到底需要什么样的知识和技能,现在还没有答案。有人说应该去学一门实用的专业(而不是技术传播专业),有人说应该学会内容评估(才能监督和管理好 AI 智能体),还有人说应该学好上下文工程、像架构师一样思考,等等。不管怎么说,有了计算器不还得先学加减乘除和手算,有了电脑和互联网不还得从小学习语数外理化?!打好基础,持续学习,以不变应万变才是硬道理。
小组讨论时,有人在评论区问技术传播学教授,他是不是应该去学哲学专业,因为大家都说 AI 来了,应该去学和人性有关的学科,学计算机没用了。教授说,我的学生都是学哲学和古典学的,他们都找不到工作,也没见谷歌和亚马逊来招哲学专业的学生,他们还是喜欢招计算机专业的。
企业行动
在本次大会上,AEM Guides 的八家新老用户分享了自己在 DITA 实施、工作流程优化以及 AI 应用等方面的实践经验。AEM Guides 是 Adobe 数字体验管理系统 (Adobe Experience Manager, AEM) 中的一个组件,专门用来创建、管理和发布 DITA 内容。AEM 的目标用户是大中型企业,因此本次大会上的这八家企业也是非富即贵,甚至还有 DITA 的开山鼻祖 IBM。
IBM
IBM 目前拥有 2000 多种产品,数十年来积累了海量的内容:剔除重复内容后,只统计英文版产品文档的话,内容量可达 2000 万页之多。在 GitHub 上,IBM 拥有大约 1500 个包含产品文档的存储库。其中,94% 的内容是用 DITA 编写的,依靠内部工具和开源工具管理和发布文档内容。
IBM 现有 1000 名左右的技术写作人员,分属多个不同的产品团队。每个团队自主管理自己的文档,按照自己的喜好选择软件工具、工作流程和管理方式。有些团队能力比较强,利用自制工具把 DITA 玩得花样百出,搞出了 38 种内部定制的主题类型。
经年累月,系统孤岛和内容孤岛问题越来越严重。各个团队的内容策略不一致,源文件多种多样,管理和支持的成本比较高,也拖慢了产品文档发布和更新的速度。近几年,AI 飞速发展,IBM 没有跟风上线 AI 助手或智能体,而是决定着手解决文档债。
进行了将近一年的前期调研和测试之后,IBM 决定将所有文档逐步迁移至 AEM Guides。在 Adobe 的帮助下,IBM 规范了文档源文件(比如将内部定制的主题类型从 38 种减少到两种),开发了转换工具、转换脚本和上传过程可视化工具等批量迁移工具,帮助各个团队在不影响当前工作的情况下实现平稳过渡。
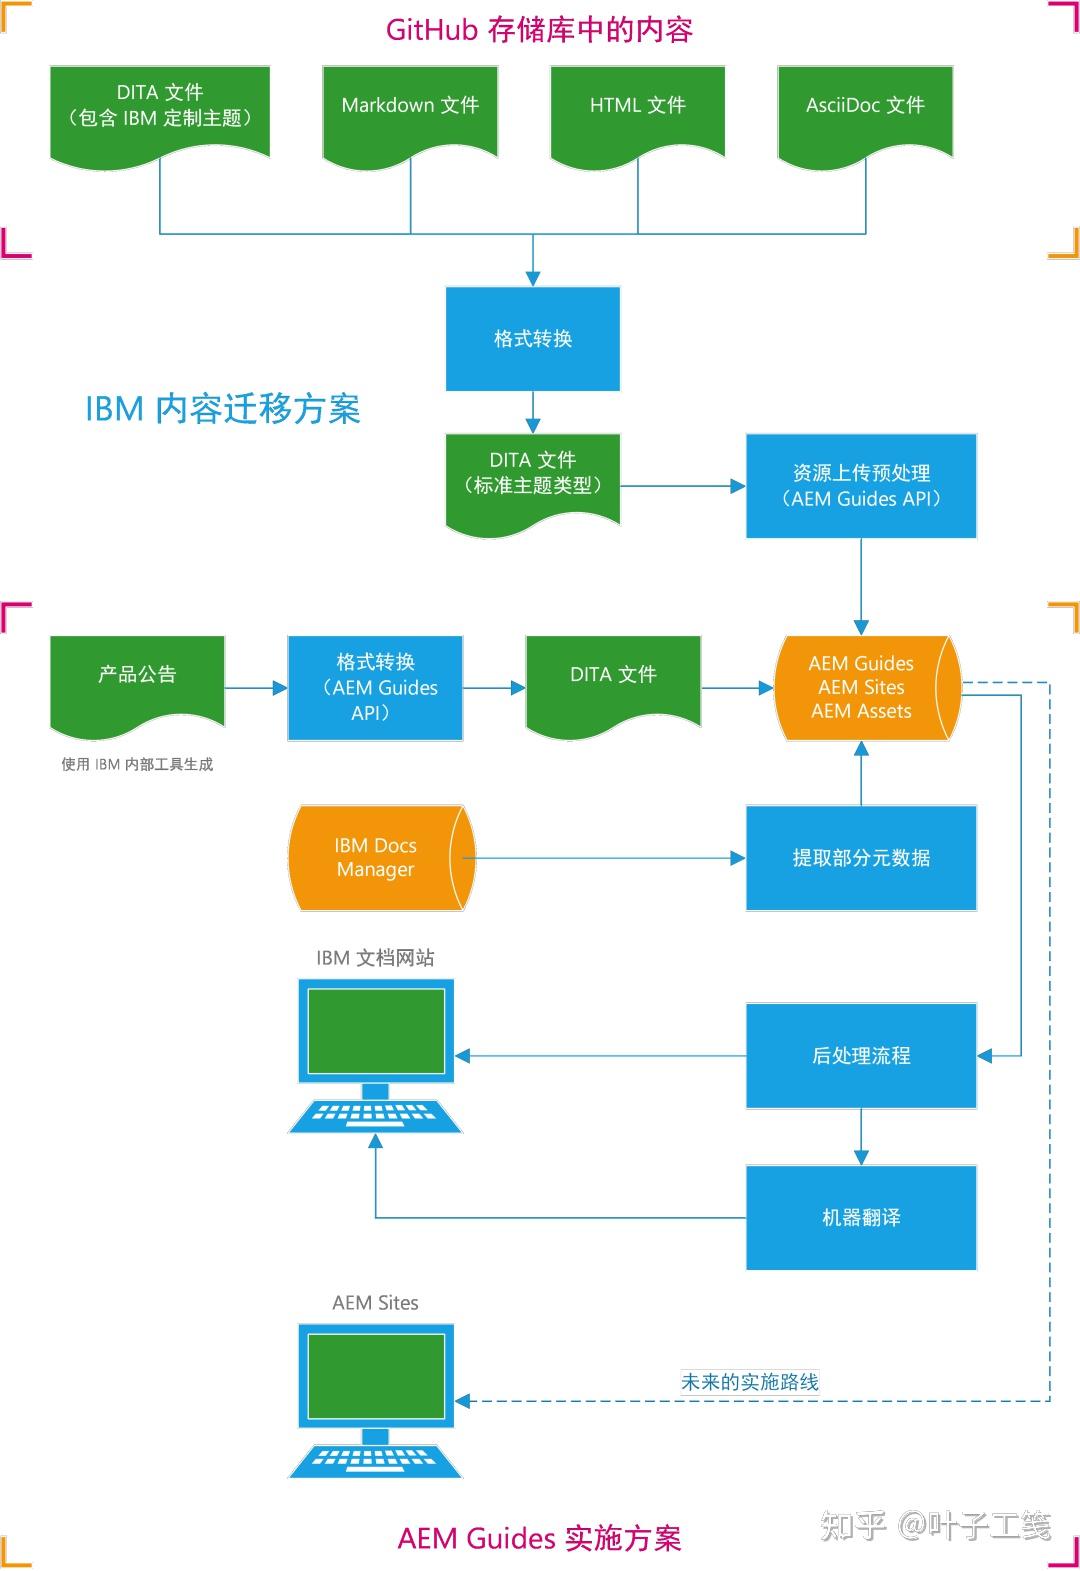
IBM 从今年 4 月 1 日开始将文档批量导入 AEM Guides,截至演讲当天(6 月 23 日)已经导入了大约 155 万份文件。现在,IBM 文档网站已经部署了基于 RAG 的 AI 助手,并且和 Adobe 产品团队一起测试了几个产品,结果表明:如果直接使用 DITA 源文件,基于 DITA 的语义化结构生成知识图谱,可以让 AI 助手的回答更精确、更靠谱,甚至能称得上质的飞跃。
西勒奇锁具
美国知名锁具公司西勒奇在咨询公司 POP 的帮助下,利用定制的 AI 工具将 InDesign 排版的文档自动转换成 DITA 文件,导入到 AEM Guides 中。这是本次大会上唯一的一个 AI 应用实例演示,让人印象深刻。
Adobe InDesign 常用于高端印刷品的排版,使用该工具设计的文档往往页面精美、布局复杂。InDesign 可以将文件导出为 IDML 格式(一种基于 XML 的结构化文档),但经常产生内容错乱。如果要将 InDesign 制作的文档转换成 DITA,往往需要大量烦琐的人工劳动。为了解决这个问题,POP 基于 Adobe Guides 的扩展框架 (Extension Framework) 开发了三个 AI 工具:
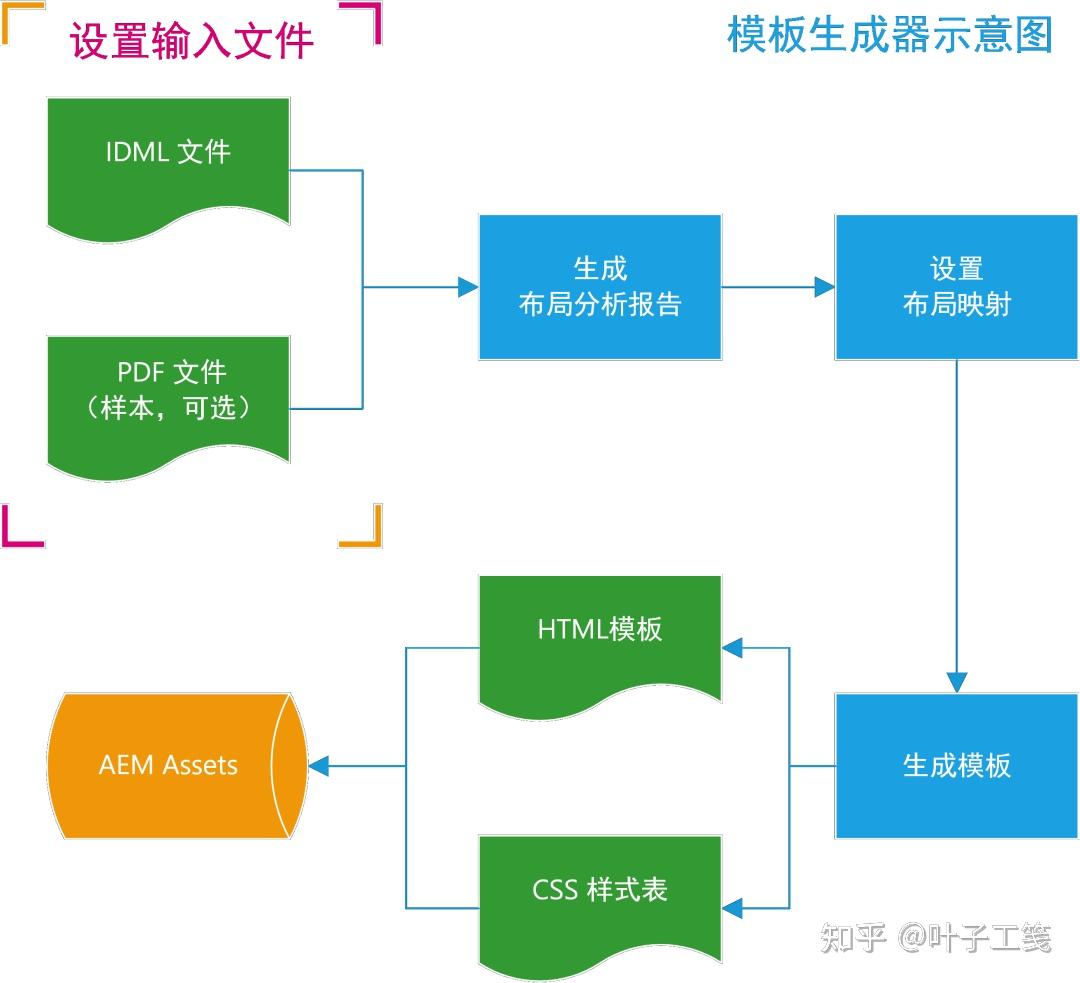
模板生成器可以分析 IDML 文件中的内容,利用视觉模型(Claude 或 Gemini)识别文档样本(PDF 文件)的页面布局,自动生成 HTML 模板和 CSS 样式表。以后将 DITA 内容发布为 PDF 格式的文档时,就会使用这些模板和样式表。
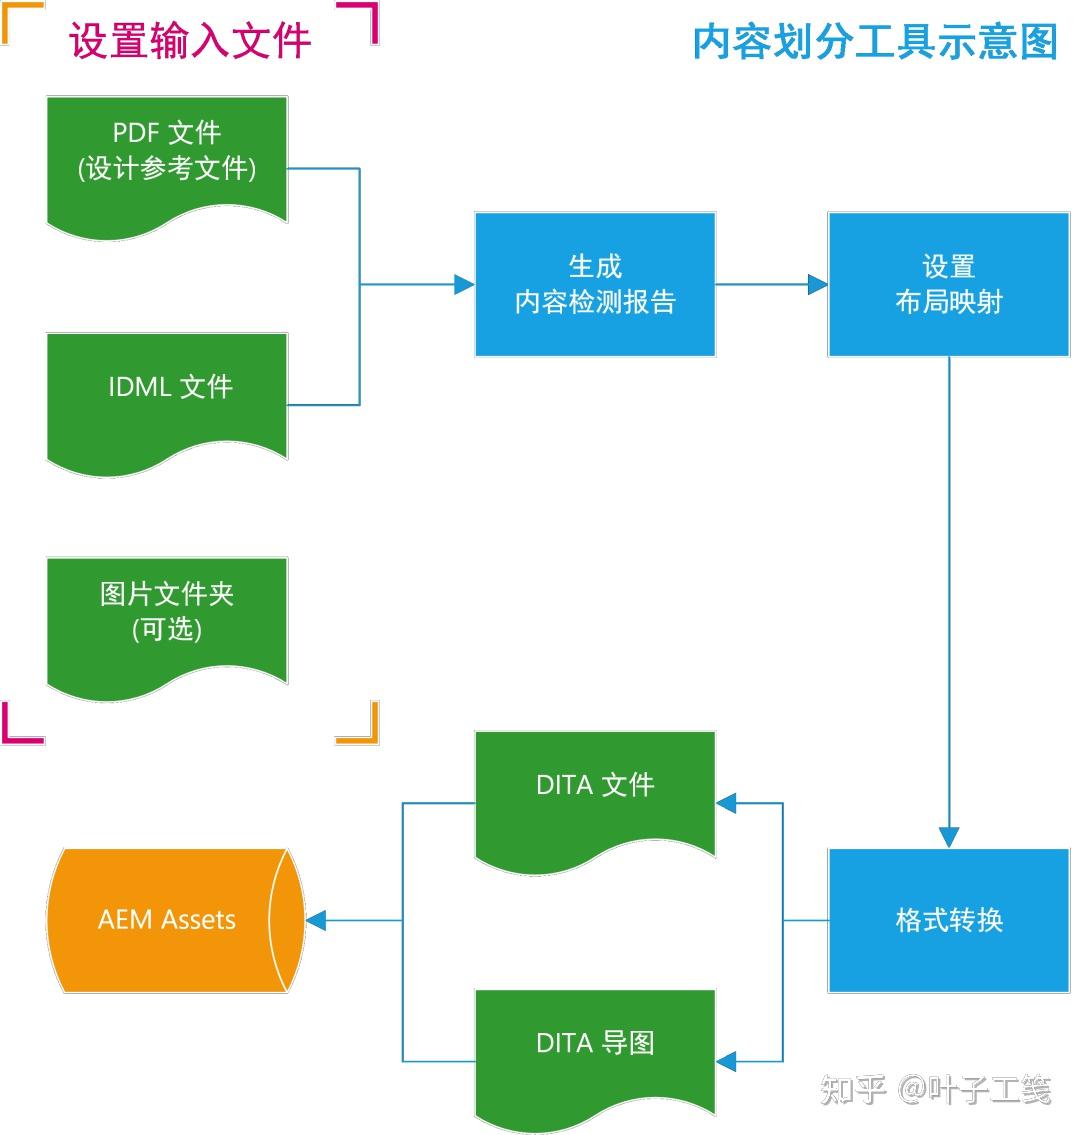
内容切分工具可以利用视觉模型识别文档样本(PDF 文件)的页面布局,提取 IDML 文件中的内容,自动生成 DITA 主题和 DITA 导图,并按照指定路径保存到 AEM Assets 中。主题划分以页面为单位,一个主题对应一个页面。
模板编辑器可以用来修改 HTML 模板和 CSS 样式表。模板生成器生成的模板和样式表可能不太完美,仍然需要进行一些人工调整。开发人员可以直接编辑 CSS 代码,普通用户可以输入提示词让 AI 帮忙修改。
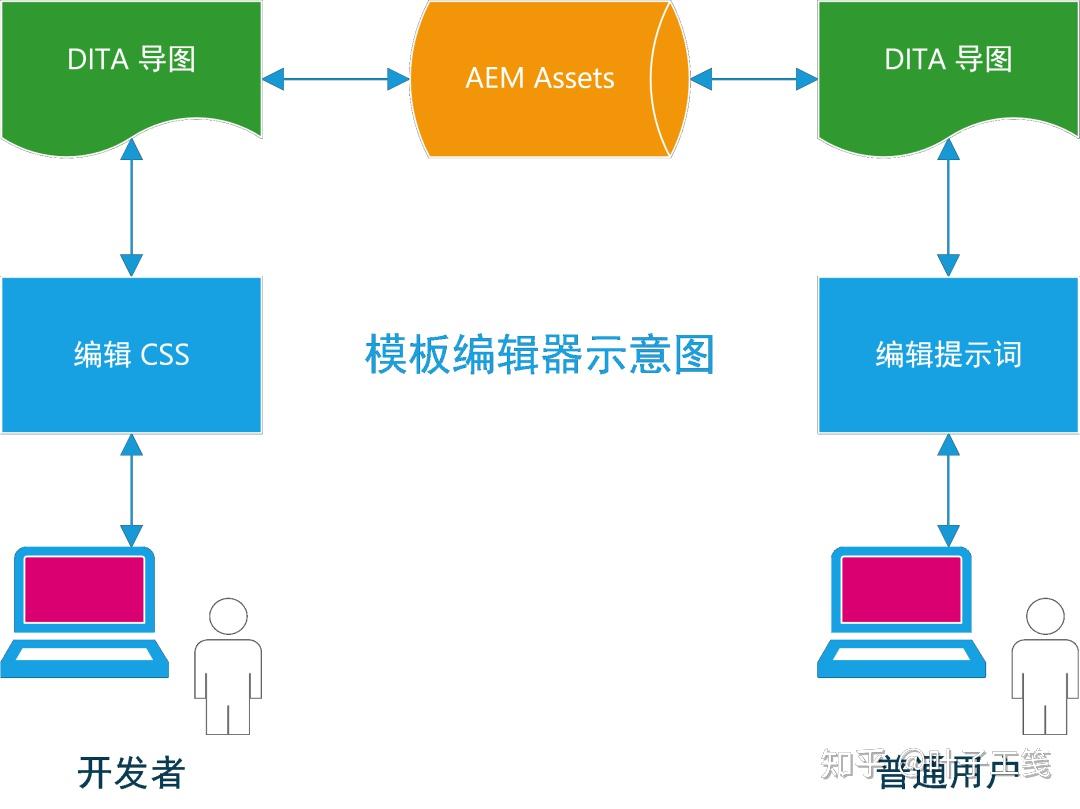
以前,开发人员得花好几天或好几星期的时间来完成这些工作。现在,AI 工具可以在 6~7 分钟内容完成 80~90% 的工作,只需要人工调整一下细节即可。
汤森路透
汤森路透是总部位于加拿大的一家专业信息服务提供商(在美国设有多个办公室),客户主要是法律、税务、会计和政务等方面的专业人士。其内容策略高级经理 Emily Byrnes 分享了她们团队在 AI 应用方面的经验和她的一些个人观点,最后还忍不住吐槽了一下业务部门对 AI 的迷思,并下决心要回去打破它。
汤森路透有一些非常硬核内容产品,结构化做得非常好,比如法律实务资源数据库 Practical Law 和全球税务信息数据库 Checkpoint Edge。基于这些产品的 AI 体验以及衍生的 AI 产品,效果都非常好。
但基于产品的帮助文档开发的 AI 工具,效果往往不尽人意。汤森路透的内容团队只有 10 来个人,管理着 200 多个产品。他们每天都很忙,没有时间将内容结构化并添加元数据。虽然他们已经将全部内容从多个不同的系统都迁移到了 AEM Guides 中,但内容还是那些内容,并没有像 IBM 那样进行系统的优化,因为公司只给了他们三周的迁移时间。
Emily Byrnes 认为,良好的 AI 体验不是有内容就行,而是得有好内容。文档本身不能直接产生利润,人们很少认真对待。每个人都觉得自己会写,甚至还可以让 AI 写。但帮助文档对内容的正确性和一致性要求很高,业务部门写的草稿通常需要写作人员重新加工、润色之后才能发布。这一点对于汤森路透的客户尤其重要,因为他们的时间就是金钱!
除此之外,美国飞机制造新秀 JetZero、存储芯片制造商美光科技 (Micron) 、打印解决方案提供商斑马技术 (Zebra)、安永(全球四大会计师事务所之一)和 3M (生产 N95 口罩的那家公司)也分享了他们在 DITA 实施方面的实践经验。红帽公司客户内容服务全球经理在小组讨论时透露,他们也正在向 DITA 转型。
专题分享
在本次大会上,四位不同领域的专家分享了自己对于 DITA 和 AI 的研究、思考和实践心得。其中,有两场演讲内容详实、实例丰富,分外精彩。
内容信任危机的技术解析
法国内容交付平台 Fluid Topics 在语义搜索、人工智能和无障碍内容方面拥有二十多年的研究和实践经验。其 CEO Fabrice Lacroix 在演讲中表示,很多公司部署 AI 应用或复杂的智能体系统之后都会或多或少地遭遇内容信任危机,主要有两方面的原因:
一是技术方面。通用大模型(比如 ChatGPT)在回答常规问题时表现得亮眼,但涉及到专业领域或企业专有内容时往往就会吃瘪。自 2022 年 ChatGPT 爆火以来,技术社区一直在尝试解决这个问题。直到 2024 年 11 月,安特匹罗克 (Anthropic) 公司发布模型上下文协议 (MCP),大家的关注点才呼啦啦地转向了智能体。
与此前的技术方案相比,智能体(比如 Claude Code、OpenClaw等)的表现已经让大众觉得很惊艳。但对于企业级应用来说,它依然有很多问题需要解决。例如,智能体可以自主决策需要访问哪个外部应用,但目前它的能力只够选择一两个外部应用来访问,再多就容易出错。还有,很多传统软件目前不支持 MCP(比如 SharePoint、Git 存储库或一些内容管理系统),有些可能永远支持不了。
| 时间 | 技术方案 | 优缺点 |
|---|---|---|
| 2022 | 模型微调 | 技术门槛高,效果不好,贵! |
| 2023 | RAG | 效果好,可以为用户设置访问权限。 只适合小规模的文档库或内容库。 |
| 2024 | 数据湖 | 试图提升 AI 基于大规模内容库或跨系统内容回答问题的能力,但效果不佳。 |
| 2025 | MCP | MCP 是智能体与外部系统进行沟通的语言。 智能体可以自己查找信息,动态构建上下文。 智能体目前最多可以与一两个系统交互,再多就容易出错。 很多传统软件不支持 MCP。 |
二是内容方面。目前的技术写作方法普遍追求至简至易,比如精益写作 (Minimalism)。很多隐性知识藏在专业人员的脑子里,不需要写进文档,比如产品的具体应用场景。如果 AI 不知道这些隐性知识,就无法做出正确的决策,尤其是那些特别复杂或者特别小众的产品。
技术方面的问题自然由科技企业和技术人员去解决。而内容方面的问题,除了全面拥抱结构化写作、提供充足的元数据之外,如何将专业人员脑子里的隐性知识转换为显性知识,写进文档里,是技术写作人员面临的又一个挑战。这么说,AI 还要给大家增加工作量了?
无障碍内容最佳实践
内容策略顾问 Bob Johnson 曾是甲骨文的高级技术写作工程师。由于多位家庭成员都是残障人士,他自 2008 年起开始关注无障碍内容。在本次演讲中,他分享了《Web内容无障碍指南》(Web Content Accessibility Guidelines,WCAG)中的四大原则和相关的准则,并为每条准则提供了 DITA 示例。
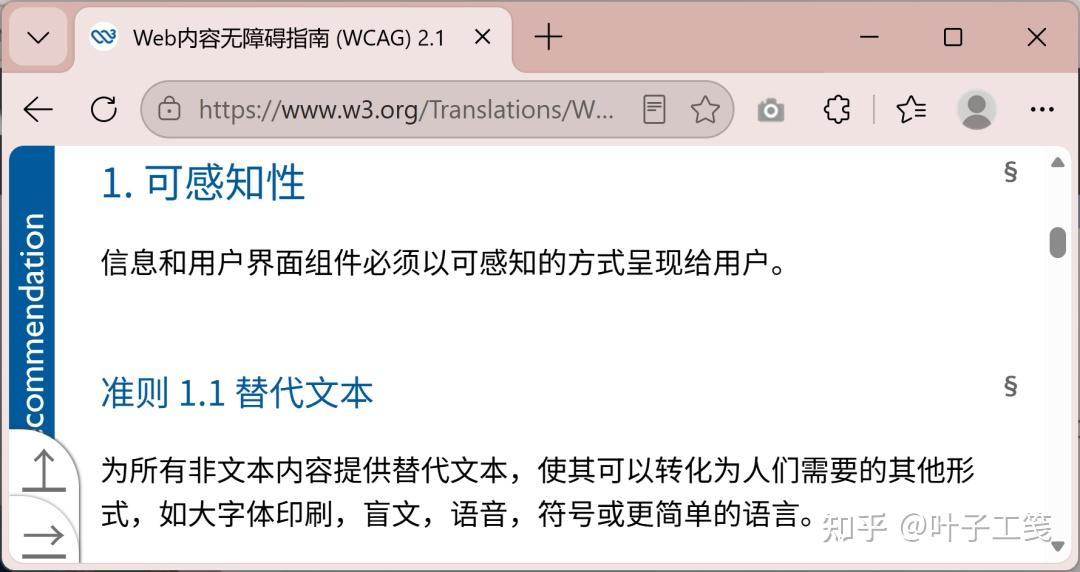
《Web内容无障碍指南》是由万维网联盟无障碍内容工作组 (W3C WAI) 编制的无障碍国际标准。该指南包含无障碍内容设计的四大原则:可感性性、可操作性、可理解性和鲁棒性。每项原则细分为若干准则,比如可感知性原则细分为四条准则,其中第一条准则是“替代文本”(见下图)。
你可能听说过图片的替代文本,或许也知道 PDF 文件和音视频也需要替代文本,因为产品文档中经常用到这些文件。可你听说过产品文档中的 ASCII 字符画,而且它也需要替代文本吗?
下面是一幅 ASCII 字符画。
  _____    ____     ____    _           _       _
 |_   _|  / ___|   | __ )  | |   __ _  | |__   | |__     ___   _ __
   | |   | |       |  _ \  | |  / _` | | '_ \  | '_ \   / _ \ | '__|
   | |   | |___    | |_) | | | | (_| | | |_) | | |_) | |  __/ | |
   |_|    \____|   |____/  |_|  \__,_| |_.__/  |_.__/   \___| |_|
Bob 举了一个非常眼熟的例子:点击“文件”>“新建”。其中的大于号并不表示它的常规语义,而是利用视觉形象充当级联菜单中的箭头,也算是 ASCII 字符画了。在这种情况下,直接输入大于号对使用屏幕阅读器的用户不太友好。在 HTML 中,推荐使用 <abbr> 元素将大于号括起来,并将 @title 属性设置为 然后。屏幕阅读器看到这里时,就会朗读:“选择文件,然后新建。”
<p>选择“文件”<abbr title="然后">></abbr>“新建”。</p>
在 DITA 中,通常使用级联菜单元素 (<menucascade>) 编写菜单操作。自 DITA-OT 2.5 开始,如果级联菜单元素使用大于号(即默认值)作为菜单分隔符,DITA-OT 会将大于号自动处理成上述形式。
类似的例子还有很多。由于篇幅关系,这里不能一一列举,以后有机会再单独分享。
AEM Guides
在本次大会上,Adobe 进行了三场关于 AEM Guides 产品的功能介绍和演示。Adobe DITAWORLD 本就是 Adobe 为了推广其内容管理系统(刚开始叫做 AEM XML 文档插件,后改名为 AEM Guides)而举办的行业会议,自然会宣传一下自家产品的新理念和新功能。
解决方案高级顾问 Mike Buoy 演示了 AEM Guides AI 中的五个智能体(导入、新建、修改、标记和验证智能体)如何协助写作人员完成从内容迁移或内容创建到内容发布的整个工作流程,如何一键启动基于 AI 大模型的翻译流程,以及如何利用 AEM Guides AI 搭建知识库并提升 AI 体验。
解决方案顾问高级经理 Divraj Singh 演示了如果利用 AEM Guides API 在不同系统之间搭建基于 AI 大模型的内容生产线。演讲中使用的示例也可以下载。
首席解决方案顾问 Leroy Steinbacher 简单介绍了 DITA 2.0 的资源结构和获取方式、DITA-OT 对 DITA 2.0 的支持情况以及在 AEM Guides 中如何通过设置 DITA Profile 来支持 DITA 2.0。想深入了解 DITA 2.0,请参见 DITA 2.0 规范草稿(位于页面最底部)。
希望了解最新的行业趋势、和同行一起探讨职业发展或者获取优质的学习资源?欢迎扫描下方二维码关注 公众号@技术传播百态说,在后台发送关键字 读者群,即可加入「技术传播百态说读者群」。读者群会不定期组织技术传播或科技相关的话题讨论,主打一个自由松弛的交流氛围。

参考资料
- DITA 2.0 Specification
- Keith Schengili-Roberts. Global Accessibility Awareness Day (GAAD) and DITA. [2014-05-15][2026-08-26].
- Bob Johnson. About Clio’s Techscribe. [未知][2026-08-26].
- Web内容无障碍指南. [2019-03-11][2026-08-26].
- DITA Open Toolkit 2.5.4 Release Notes. [未知][2026-08-27].